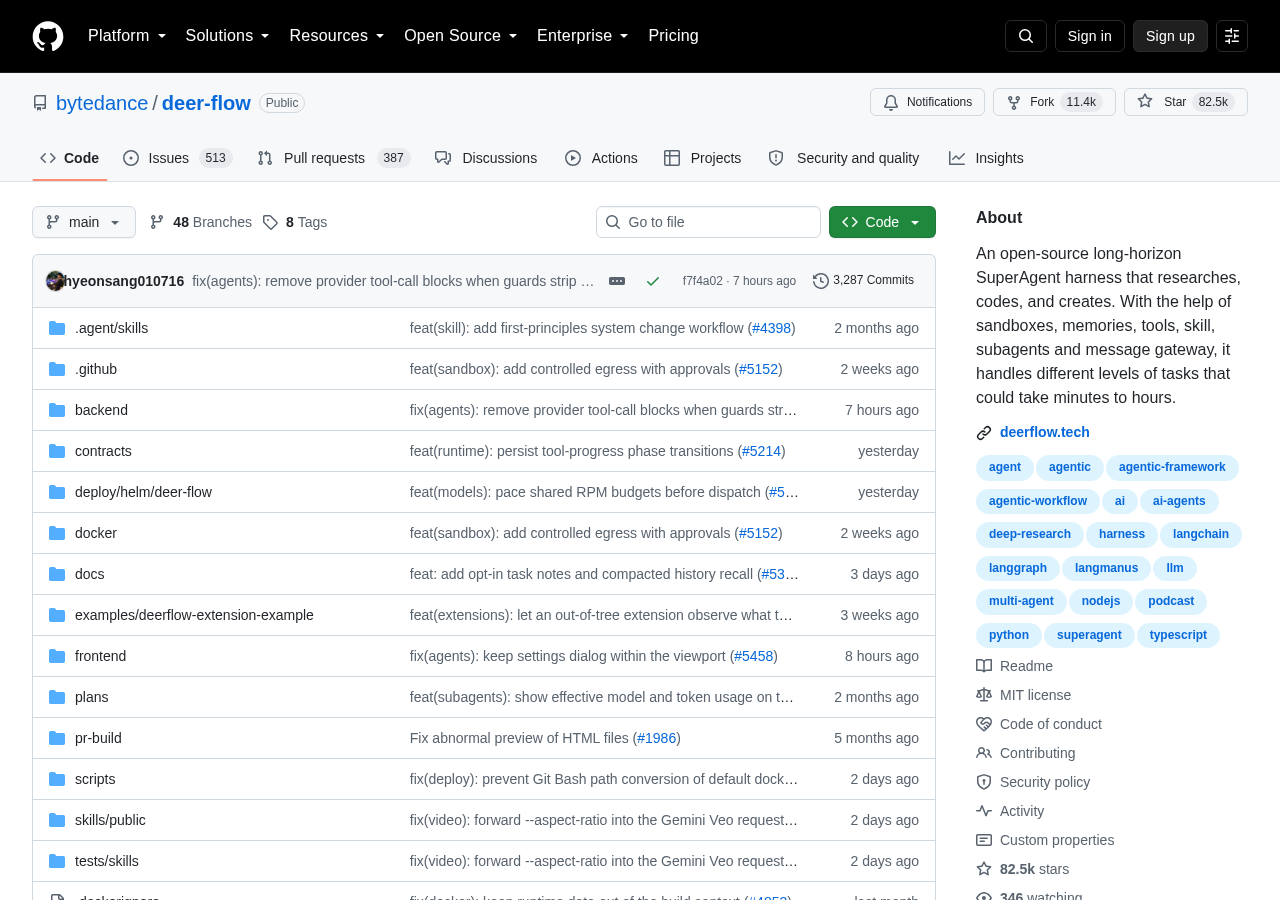
大家好,今天给大家介绍一个在 GitHub 上狂揽 82K+ Star 的超级智能体框架——DeerFlow 2.0。它是字节跳动开源的,2026年2月底发布后直接登顶 GitHub Trending 榜首,不到一个月就拿下近 5 万 Star。
简单来说,DeerFlow 不是又一个聊天机器人,而是一套真正能让 AI 自主执行复杂任务的运行时基础设施。它能帮你做深度调研、写报告、分析数据、甚至写代码——给 AI 一台带大脑的电脑,让它自己干完整个项目。
文章目录
一、DeerFlow 是什么?
DeerFlow 全称 Deep Exploration and Efficient Research Flow,由字节跳动团队开发。
它的 v1(2025年5月)定位是深度研究框架,让 AI 像研究员一样制定调研计划、分头搜集信息、交叉验证,最后交付有引用、有深度的报告。7 天内就拿了 1 万 Star。
到了 v2(2026年2月27日),团队进行了彻底重写,与 v1 不共享一行代码。从单一深度研究工具升级为通用超级智能体运行时(Super Agent Harness)。v1 是”帮你查资料写报告”,v2 是”给你一台 AI 大脑的电脑,让它自己干完项目”。
二、核心架构:为什么它这么强?
DeerFlow 2.0 的核心架构是 “主智能体 + 中间件链 + 动态子智能体”的分层协同设计,基于 LangGraph 1.0 和 LangChain 构建。
服务拓扑是四进程协同:
| 服务 | 技术栈 | 端口 | 职责 |
|---|---|---|---|
| Frontend | Next.js + Zustand | 3000 | Web UI、SSE 流式交互 |
| Gateway API | FastAPI | 8001 | REST API、IM 通道 |
| LangGraph Server | langgraph dev | 2024 | 核心智能体编排引擎 |
| Provisioner(可选) | FastAPI | 8002 | K8s Pod 管理 |
11层中间件链是 v2 架构最精巧的设计。每层实现一个钩子,职责单一、可独立测试:
| 序号 | 中间件 | 核心职责 |
|---|---|---|
| 1 | ThreadDataMiddleware | 创建线程级隔离目录 |
| 2 | UploadsMiddleware | 注入用户上传文件列表 |
| 3 | SandboxMiddleware | 获取沙箱实例 |
| 4 | DanglingToolCallMiddleware | 处理孤立的工具调用 |
| 5 | SummarizationMiddleware | 超 token 阈值时自动摘要 |
| 6 | TodoListMiddleware | 规划模式下提供写入工具 |
| 7 | TitleMiddleware | 自动生成会话标题 |
| 8 | MemoryMiddleware | 异步提取对话记忆 |
| 9 | ViewImageMiddleware | 注入图像数据 |
| 10 | SubagentLimitMiddleware | 限制并发子智能体数量 |
| 11 | ClarificationMiddleware | 拦截澄清请求 |
三、五大核心创新
1. 执行优先的沙箱隔离
这是 DeerFlow 与大多数 Agent 框架最本质的区别。DeerFlow 的 Agent 不只是”会说话”,它有自己的计算机。每个任务运行在隔离的 Docker 容器中,拥有完整的文件系统和 Bash 执行能力。Agent 可以读写文件、执行命令、运行 Python 脚本、安装依赖包。
沙箱文件系统结构清晰:/mnt/user-data/uploads/ 存放用户文件,/mnt/user-data/workspace/ 是工作目录,/mnt/user-data/outputs/ 存放最终交付物。任务结束即销毁,会话之间零污染。
2. 渐进式技能加载
DeerFlow 内置了深度研究、报告生成、幻灯片制作、网页生成、图像生成、视频生成等技能。真正的亮点在于渐进式加载——技能仅在任务需要时才被加载到上下文中,而非一次性全部载入。这让 DeerFlow 即使使用 token 敏感的模型也能高效运行。
3. 持久化长期记忆
记忆系统采用基于事实的存储模式,每条记忆包含 id、内容、分类(偏好/知识/上下文/行为/目标)、置信度(0-1)。每次交互时,系统从记忆库中提取最多 15 条最相关事实注入系统提示。
4. 子智能体分治策略
复杂任务被自动分解。Lead Agent 可以随时通过 task 工具生成子智能体,每个子智能体拥有独立的上下文、工具集和终止条件。最多 3 个并行执行,15 分钟超时。用户报告这种并行模式带来 3-5 倍的效率提升。
5. Human-in-the-loop 人机协同
在关键决策节点设置人工干预机制。Planner 生成研究计划后会暂停执行,等待用户用自然语言修改或确认。用户可以接受、编辑计划,或让系统自动继续。
四、快速上手安装
环境要求
| 部署方式 | 最低配置 | 推荐配置 |
|---|---|---|
| 本地开发 | 4 vCPU, 8GB RAM | 8 vCPU, 16GB RAM |
| Docker 开发 | 4 vCPU, 8GB RAM | 8 vCPU, 16GB RAM |
| 长期服务 | 8 vCPU, 16GB RAM | 16 vCPU, 32GB RAM |
方式一:Docker 部署(推荐)
# 克隆仓库
git clone https://github.com/bytedance/deer-flow.git
cd deer-flow

# 运行安装向导(交互式,选模型+配置)
make setup

# 启动服务
make docker-start
启动后访问 http://localhost:2026 即可看到 Web UI。
方式二:本地开发
# 克隆仓库
git clone https://github.com/bytedance/deer-flow.git
cd deer-flow

# 运行安装向导
make setup

# 启动开发模式
make dev
配置模型
安装向导会引导你选择 LLM 提供商。官方推荐豆包 Seed-2.0-Code、DeepSeek v3.2 和 Kimi 2.5。
你也可以手动编辑 config.yaml,配置 OpenAI 兼容的任何 API,包括 GPT-4o、Claude、Gemini、通过 Ollama 接入的本地模型等。
五、实战:让 DeerFlow 帮你做调研
假设你想调研”2026年国内大模型生态”,在 DeerFlow 的 Web UI 中输入:
帮我调研2026年国内主流大模型的生态现状,包括DeepSeek、通义千问、豆包、Kimi等,
从技术架构、开源生态、商业化进展三个维度分析,输出一份带引用来源的分析报告。
DeerFlow 会自动:
- 制定调研计划:拆分为多个子话题
- 派出子智能体:每个子智能体负责一个子话题,并行搜索和整理
- 交叉验证:主智能体汇总子智能体的结果,进行分析整合
- 生成报告:输出带引用的结构化分析报告
整个过程可能需要几分钟到十几分钟,你可以在 Web UI 上实时看到 Agent 的思考过程和执行步骤。
六、与主流框架对比
| 框架 | Star | 特点 | 适合场景 |
|---|---|---|---|
| DeerFlow 2.0 | 82K+ | 沙箱隔离+子智能体+持久记忆 | 复杂任务执行、企业级部署 |
| AutoGPT | 183K | 最大社区,单智能体循环 | 实验探索 |
| MetaGPT | 64K | SOP 模拟软件公司 | 软件工程自动化 |
| CrewAI | 44K | 预定义角色,上手简单 | 快速原型、轻量协作 |
| AutoGen | 25K | 对话式多智能体(维护模式) | 研究实验 |
七、注意事项
1. 项目非常年轻:v2 发布才几个月,没有大规模企业生产部署案例。建议在非敏感工作负载上先做试点。
2. 资源消耗不低:多智能体并行运行在 Docker 容器中,对基础设施有一定要求。使用本地模型的话需要较强的 GPU。
3. API 调用成本:使用 GPT-4o 等顶级模型做深度调研,单次任务费用可能在 1.5-2 美元。可以使用本地模型或性价比更高的模型来控制成本。
4. MIT 开源协议:商用无法律障碍,代码完全可审计。
八、总结
DeerFlow 2.0 代表了开源 AI Agent 从”对话玩具”向”工业级自动化生产力工具”的关键跃迁。它的核心贡献不在于发明新算法,而在于将 LangGraph 状态编排、Docker 沙箱隔离、渐进式技能加载、持久化记忆、动态子智能体分治等成熟理念,整合成一套真正可用的超级智能体运行时。
如果你是开发者,想体验让 AI 自主完成复杂任务的能力,DeerFlow 2.0 是 2026 年最值得关注的开源项目之一。
📎 GitHub 地址:https://github.com/bytedance/deer-flow
📎 官方网站:https://deerflow.tech
💬 关注公众号:「实用软技」,在公众号窗口里回复关键字「软件」即可免费获取
https://www.88531.cn/?p=56065
创作不易,用心坚持,请喝一怀爱心咖啡!继续坚持创作~~